波场合成的物理基础与声场重构原理
波场合成(Wave Field Synthesis,简称WFS)的核心逻辑源于惠更斯-菲涅耳原理,该原理指出空间中任意一点的声压场可以视为由次级源发出的球面波叠加而成。在虚拟声源构建的过程中,系统不再像传统立体声那样依赖扬声器间的相位差和强度差来模拟方向感,而是通过密集排列的扬声器阵列,精确计算出每个扬声器在任意时刻需要输出的信号,以重构出声源发出的完整声波前。这种技术能够同时重现声源的距离、方向以及近场效应,使得听众在听到声音时,声像仿佛真实位于扬声器阵列前方的某个物理位置,而非传统录音中那种被压缩在两个扬声器之间的平面声像。
为了实现这一目标,WFS系统需要解决从离散扬声器到连续次级源的理论映射问题。根据声学理论,当扬声器数量足够多且间距小于当前频率对应的半波长时,离散阵列可以近似为连续的次级源线或面。通过求解二维或三维亥姆霍兹方程,算法能够推导出为了在听音区域内产生一个位于特定点的虚拟声源,各个扬声器应辐射的声压分布。这种基于物理声学的建模方式,使得重构的声场具有极高的空间准确性,特别是在大尺寸听音区域内,能够保持声像位置的稳定性,避免了传统多声道系统在移动听音位置时声像漂移或模糊的问题。
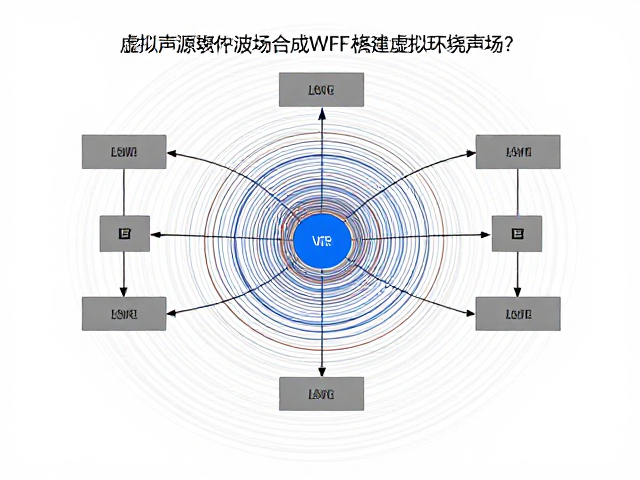
核心算法架构与信号处理流程
WFS的重构过程依赖于严密的数学模型,主要分为二维WFS和三维W-SWS(三维波场合成)两种主要架构。在二维情况下,假设声源和听音区域位于同一水平面,系统利用线阵列扬声器,通过求解格林函数计算每个扬声器的驱动信号。这一过程涉及对原始声源信号进行空间滤波和延迟处理,以补偿声波从虚拟声源位置传播到各个扬声器位置的路径差异。对于三维声场,则需要处理球面波或柱面波,算法复杂度显著增加,通常需要引入近场补偿滤波器,以修正由于扬声器阵列有限尺寸导致的低频响应下降和高频混叠现象。
信号处理的实时计算是WFS实现的关键挑战。系统需要处理海量的数据流,因为每个扬声器通道都需要独立计算其驱动信号,且计算量随扬声器数量和频段范围呈指数级增长。现代WFS处理器通常采用基于FFT(快速傅里叶变换)的多频段处理技术,将音频信号分割为多个子带,分别进行空间滤波和时延校正,通过逆FFT重组为时域信号。此外,为了应对高频段的空间混叠,算法中常采用临界采样策略,即根据系统的最高工作频率确定扬声器的最小间距,确保在奈奎斯特频率以下能够准确重构声波前,从而在可听范围内提供无缝且自然的环绕声体验。
听音区域优化与空间声学特性
WFS构建的虚拟声场最显著的优势在于其广阔的最佳听音区域(Sweet Spot)。与传统多声道系统中听音者必须坐在“皇帝位”才能获得最佳声像定位不同,WFS通过重构整个声场,使得在扬声器阵列前方的较大矩形或扇形区域内,听众都能体验到一致的声像位置和音质特性。这种特性源于声场重构的全局性,系统不仅关注听音点的声压,而是关注整个听音区域内的声压分布。通过优化扬声器阵列的几何形状和间距,可以进一步扩展有效听音区的宽度和深度,使多人同时聆听时,每个人都能感受到相同的虚拟声源位置,极大地提升了沉浸式体验的一致性。
然而,虚拟声场的构建效果受到房间声学特性的显著影响。实际环境中的墙壁反射、混响以及背景噪声会干扰重构的直达声场,导致声像模糊或定位错误。为了应对这一问题,WFS系统通常结合房间声学测量数据,对驱动信号进行预加重或去卷积处理,以抵消房间模态带来的负面影响。此外,部分高级WFS算法引入了主动噪声控制或反射管理策略,通过在扬声器阵列后方或侧面布置辅助扬声器,抵消或管理来自墙壁的早期反射声,从而在非消声室环境下也能维持较高的虚拟声源清晰度和空间感,使重建的声场更接近自由场中的理想状态。