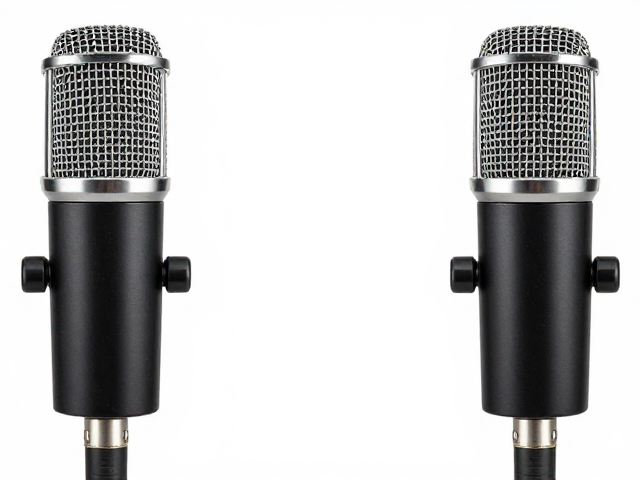
双麦克风阵列的声学协同逻辑
双麦克风设计并非简单的硬件堆叠,其核心在于利用声源定位与信号差分算法来剥离环境噪音。当声音从正前方传入时,两个麦克风接收到的信号相位基本一致,系统通过加法运算增强正向声压;而来自侧面或后方的背景噪音,由于到达两个麦克风的时间差和相位差异较大,在差分处理中会被大幅削弱。这种物理结构配合算法,能有效区分说话人语音与环境底噪,为清晰录音奠定硬件基础。
在实际应用中,这种架构能显著降低单点收音的盲区与失真风险。即便使用者在直播过程中出现轻微的头部晃动或偏离中心位置,双麦阵列仍能通过空间音频算法锁定声源方向,保持声音主体的稳定性。相较于单麦克风容易因角度偏差导致声音忽大忽小,双麦结构提供了更宽的有效拾音角度,使得声音采集更加跟手且自然,避免了因位置微调带来的音质断层。
自适应增益控制的动态平衡
自适应增益管理是解决直播录音中爆音与底噪共存的关键技术。当主播音量突然增大或情绪激动时,系统能实时监测输入信号电平,自动降低增益以防止削波失真;而在轻声细语或停顿间隙,系统则迅速提升增益以捕捉细微音色,同时抑制因增益提升带来的电子底噪。这种毫秒级的动态调整,确保了全程音频响度的一致性,避免了人工频繁调节推子带来的操作焦虑。
该机制通过数字信号处理单元持续分析音频波形特征,区分瞬态峰值与稳态信号。在面对敲击桌面、翻动纸张等突发性冲击噪声时,自适应算法能识别出色块特征并进行快速压制,而非简单地降低整体音量。这种智能化的电平控制,使得录音文件在后期处理或直接推流时,无需依赖复杂的压缩器或限幅器即可获得干净、通透且动态范围合理的音频信号。
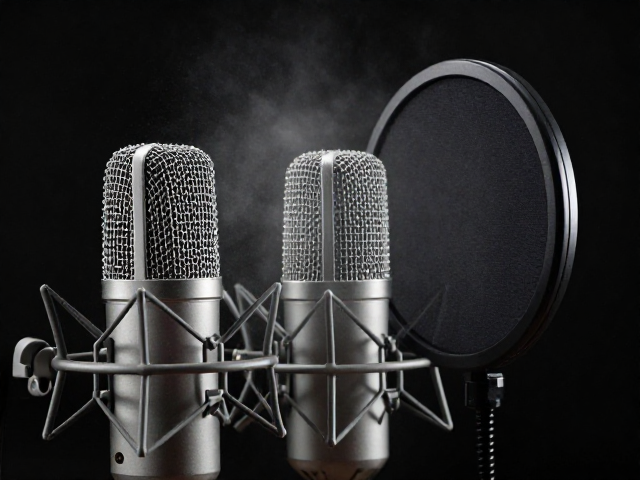
防风罩的气流物理隔离
防风罩的作用原理基于流体力学中的湍流消散机制,而非简单的声音阻挡。当空气快速掠过麦克风振膜时,会产生非声源的压力波动,即风噪。多层高密度海绵或金属网构成的防风罩,能强制改变气流路径,将高速直线气流转化为低速紊乱的涡流,从而消除对振膜的直接冲击。这种物理隔离层能有效过滤日常说话产生的喷麦现象,以及室内空调风或室外微风带来的低频轰鸣。
对于户外直播或强风环境,防风罩的仿生毛皮设计(俗称“死猫”)能进一步增加空气阻力面积,通过复杂的纤维结构打散大尺度风团。即便在室内安静环境下,防风罩也能减少唇齿音产生的近场气流对振膜的直接扰动,提升语音的清晰度与耐听度。合理的防风罩选型与安装,能确保声音细节不被物理配件所遮蔽,同时彻底隔绝由气流运动引发的低频噪音干扰。
直播场景的纯净声音构建
在直播录音中,清晰无杂音的结果是硬件架构、算法处理与物理防护共同作用的产物。双麦克风提供了精准的声源锁定与降噪基础,自适应增益确保了信号电平的动态稳定,而防风罩则从物理层面切断了气流噪音的来源。这三者结合,构建了一个严密的声学防护网,使得最终输出的音频既保留了声音的情感细节,又剔除了环境干扰。
这种组合方案降低了用户对后期音频修复的依赖,实现了“所见即所得”的录音效果。无论是长时间直播导致的音量波动,还是突发的环境噪音,系统都能通过内部协同机制进行实时修正。对于需要高音质输出的直播内容,这种从采集源头解决问题的思路,能够显著提升观众的听觉体验,确保信息传递的准确与高效。